

PLACES_COUNT_PER_TYPE_V2 函数会返回一个 BigQuery 表,其中包含多个输入地理位置的地点数量和示例地点 ID(按地点类型细分)。此函数旨在通过接受地理位置的输入表参数来实现高效的批量处理。您可以通过输入表提供地理位置,并将地点类型指定为数组。
语法
SELECT * FROM `PROJECT_NAME.LINKED_DATASET_NAME.PLACES_COUNT_PER_TYPE_V2`(
  TABLE input_geographies,
  target_types,
  filters
)
参数
PROJECT_NAME:您的 Google Cloud 项目的名称。LINKED_DATASET_NAME:包含地点数据分析函数的 BigQuery 数据集的名称(例如places_insights___us)。input_geographies:包含要分析的地理位置的 BigQuery 表。此表必须包含以下列:target_types(ARRAY<STRING>):您要获取其数量的地点类型字符串数组。如果地点与types数组中列出的任何类型匹配,而不仅仅是primary_type,则系统会将其计入。filters(JSON):一个 JSON 对象,其中包含用于对地点进行额外过滤的键值对。请参阅过滤条件参数。
输出表架构
PLACES_COUNT_PER_TYPE_V2 函数会返回一个包含以下列的表:
| 列名称 | 数据类型 | 说明 |
|---|---|---|
geo_id |
STRING | 输入地理位置的唯一标识符,来自 input_geographies 表。 |
input_geography |
GEOGRAPHY | input_geographies 表中的原始 GEOGRAPHY 对象。 |
place_type |
STRING | 此行表示的 target_types 数组中的地点类型。 |
place_count |
INTEGER | 地理位置内或附近与 place_type 和其他过滤条件匹配的地点数量。 |
sample_place_ids |
ARRAY<STRING> | 一个数组,其中最多包含 250 个符合此类型和地理位置条件的地点 ID。 |
输出将包含 target_types 数组中指定的每个 geo_id 和 place_type 组合对应的一行,即使计数为零也是如此。
运作方式
该函数会处理 input_geographies 表中提供的每个地理位置。对于每个地理位置,它会统计符合 target_types 数组中列出的任何类型,并且满足 filters JSON 对象中所有条件的地点。结果会按每个 geo_id 和 target_types 中的每种类型进行汇总和细分。
示例:统计纽约市各县不同类型餐馆的数量
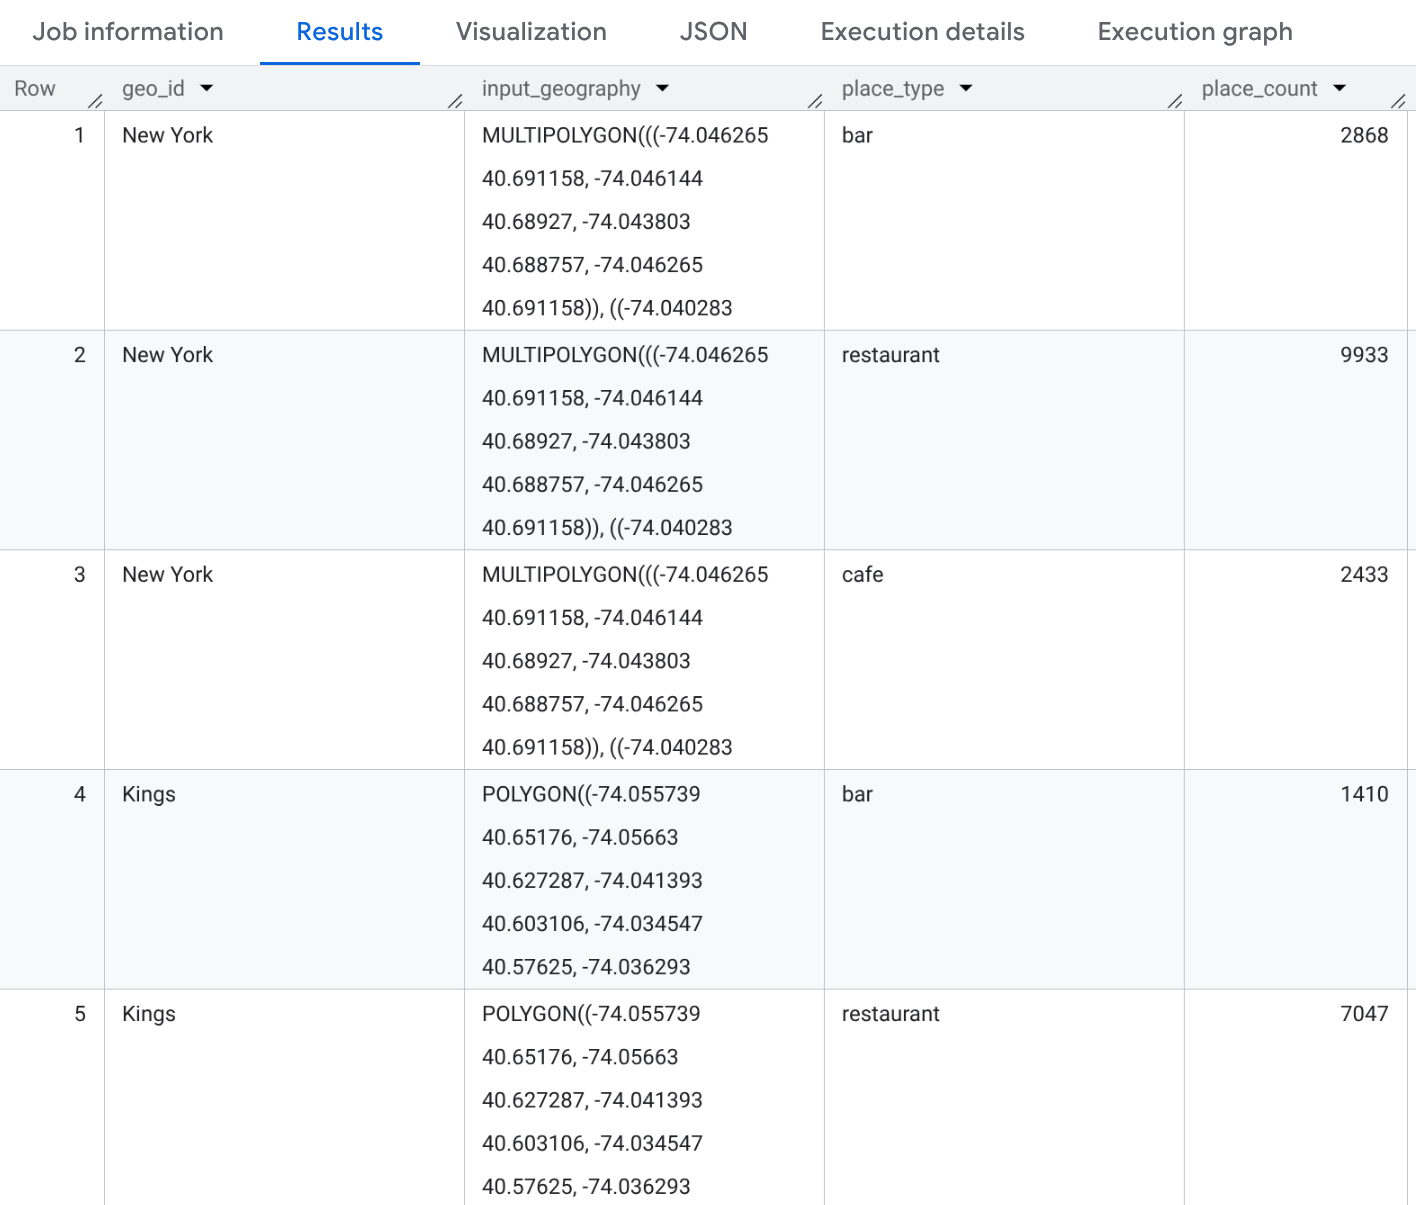
此示例会生成一个表格,其中包含纽约市三个县的“restaurant”“cafe”和“bar”类型的计数。
SELECT geo_id, input_geography, place_type, place_count
FROM `PROJECT_NAME.places_insights___us.PLACES_COUNT_PER_TYPE_V2`(
  (
    SELECT county_name AS geo_id,
           ST_SIMPLIFY(county_geom, 100) AS geo
    FROM
      `bigquery-public-data.geo_us_boundaries.counties`
    WHERE
      state_fips_code = "36"  -- New York State
      AND county_name IN ("Queens", "Kings", "New York")
  ),
  ['restaurant', 'cafe', 'bar'],  -- target_types
  JSON_OBJECT(
      'business_status', ['OPERATIONAL']
  )
);
结果将是一个包含 9 行(3 个县 * 3 种类型)的表。每行将显示每个县内“餐厅”“咖啡馆”或“酒吧”场所的数量。如果您将地点 ID 添加到 SELECT 语句中,还可以添加示例地点 ID。
使用 PLACES_COUNT_PER_TYPE_V2 的好处
PLACES_COUNT_PER_TYPE_V2 具有多项关键优势,尤其是与旧版 PLACES_COUNT_PER_TYPE 函数相比:
- 批量处理地理位置:与一次处理一个地理位置的
PLACES_COUNT_PER_TYPE不同,PLACES_COUNT_PER_TYPE_V2接受输入地理位置的TABLE。这样,您就可以在单个查询中分析和获取多个地理位置(点、多边形)的特定类型计数,而无需进行多次函数调用。 - 增强的性能和可伸缩性:通过接受表输入,
PLACES_COUNT_PER_TYPE_V2可以利用 BigQuery 优化的地理空间联接和并行处理功能,同时处理所有提供的地理位置。这样一来,在处理大量地理位置时,性能会显著提升,可伸缩性也会提高。 - 包含零计数:对于在批次中特定区域内未找到的类型,返回计数为 0 的行,从而确保所有类型-地理位置组合都有完整的结果集。
- 历史快照:使用可选的
snapshot_date过滤条件查询特定月份的地点数量数据。
示例:使用特定过滤条件按类型查询历史 POI 数量
此示例演示了如何使用 snapshot_date 参数检索过去一个月的计数,从而查找特定地点类型(例如电动车辆充电站)的计数。它会应用额外的过滤条件,让 regular_opening_hours 仅查找周末全天营业的地点,并让 min_ev_charge_connector_count 指定电动汽车充电桩可用性(至少有 10 个可用连接器)。
SELECT *
FROM `PROJECT_NAME.places_insights___us.PLACES_COUNT_PER_TYPE_V2`(
  (
    SELECT county_name AS geo_id,
           ST_SIMPLIFY(county_geom, 100) AS geo
    FROM
      `bigquery-public-data.geo_us_boundaries.counties`
    WHERE
      state_fips_code = "36"  -- New York State
      AND county_name IN ("Queens", "Kings", "New York")
  ),
  ['electric_vehicle_charging_station'], -- target_types array
  JSON_OBJECT(
    'geography_radius', 10000,
    'snapshot_date', '2026-01', -- Target snapshot month (YYYY-MM)
    'min_ev_charge_connector_count', 10, -- Look for a min amount of chargers
    'regular_opening_hours', JSON_OBJECT(
      'saturday', [JSON_OBJECT('start_time', '00:00', 'end_time', '23:59')], 'sunday', [JSON_OBJECT('start_time', '00:00', 'end_time', '23:59')]
    )
  )
);